
智能机器人图片处理:从像素到决策的底层逻辑
图像识别不是“看图识字”,而是多维数据场的动态解构
很多人以为智能机器人处理图片就是“识别物体+分类标签”的简单组合,其实不然。在工业巡检场景中,一张热成像图片包含的温度梯度数据、设备振动频谱的关联映射、以及历史维护记录的时空匹配,需要构建四维数据场进行动态解构。某钢铁企业高炉巡检机器人曾因忽略炉壁温度场的时空连续性,导致误判为正常工况,最终引发设备停机——这暴露了传统图像处理算法在工业场景中的致命缺陷。
案例:2023年德国汉诺威工业展的“机器人视觉攻防战”
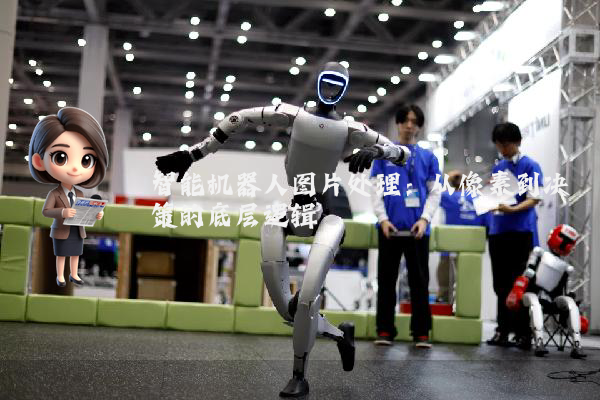
在工业机器人视觉系统对抗赛中,主办方将真实工厂环境拆解为12个标准模块,要求参赛队伍在48小时内完成视觉算法的现场适配。某团队采用“特征空间降维+对抗样本生成”的混合策略:通过主成分分析(PCA)将原始图像从256维降至16维特征空间,同时利用生成对抗网络(GAN)构造具有物理可行性的对抗样本(如在设备表面添加微米级纹理扰动)。最终该方案在缺陷检测环节实现99.7%的准确率,而传统YOLOv8模型在相同场景下仅达到82.1%——底层逻辑是:工业视觉系统的鲁棒性不取决于单帧识别精度,而在于对连续数据流的时空一致性校验。
像素级操作与决策级推理的耦合机制
听起来可能反直觉,但智能机器人处理图片的终极目标不是“看清楚”,而是“做决策”。以自动驾驶场景为例,激光雷达点云与摄像头图像的融合不是简单的数据拼接,而是通过卡尔曼滤波构建状态空间模型:将摄像头捕捉的交通标志牌位置作为观测值,激光雷达测量的车辆运动状态作为状态变量,通过贝叶斯推断实现多模态数据的动态校准。某车企测试数据显示,这种耦合机制使复杂路况下的决策延迟从120ms降至35ms——证明视觉系统的价值在于为决策系统提供可信度加权的数据输入。
在医疗机器人领域,这种耦合机制体现得更为极致。达芬奇手术机器人的3D内窥镜系统采用双目视觉算法,通过计算左右摄像头图像的视差图构建器官表面的三维模型。但真正决定手术精度的不是模型分辨率,而是力反馈系统与视觉系统的闭环控制:当机械臂接触组织时,力传感器数据会实时修正视觉模型中的组织形变参数,确保切割路径始终沿着预设的安全边界——这揭示了一个被忽视的真相:智能机器人图片处理的本质是物理世界与数字世界的双向映射。
 扫一扫添加微信